10 道 Evo 原题:实际结果
本次汇总:2026-10-31 17:54,北京时间。
连接恢复后的补充实验
本报告包含原轮保留的成果,以及连接恢复后的补跑和后续版本。三处中断各追加最多一小时,原调用和时间继续计入。已经明确失败的改进不重试。
| 模型 | 补跑位置 | 当前结果 | 额外用时 |
| DeepSeek Flash | 第一次改进 | 追加时间用完,未完成交接 | 60.3 分钟 |
| GPT 6.1 | 生产排程开发题 | 已补齐并评分 | 31.4 分钟 |
| Qwen 3.8 Flash | 薪酬工作簿独立题 | 已补齐并评分 | 2.3 分钟 |
后代改进仍只收到原来的开发题反馈。研究者已经查看过原轮独立题,这些新增结果用于检查接续后的表现,主结论需要在新独立题上重复。
计划让六个模型从同一份程序出发,用五道开发题改进两次,再用另外五道原题比较各代。每个模型运行一条链。
独立题:55/55 份已评分,0 份服务中断,0 份待评分。匿名比较:66/66 组已完成。
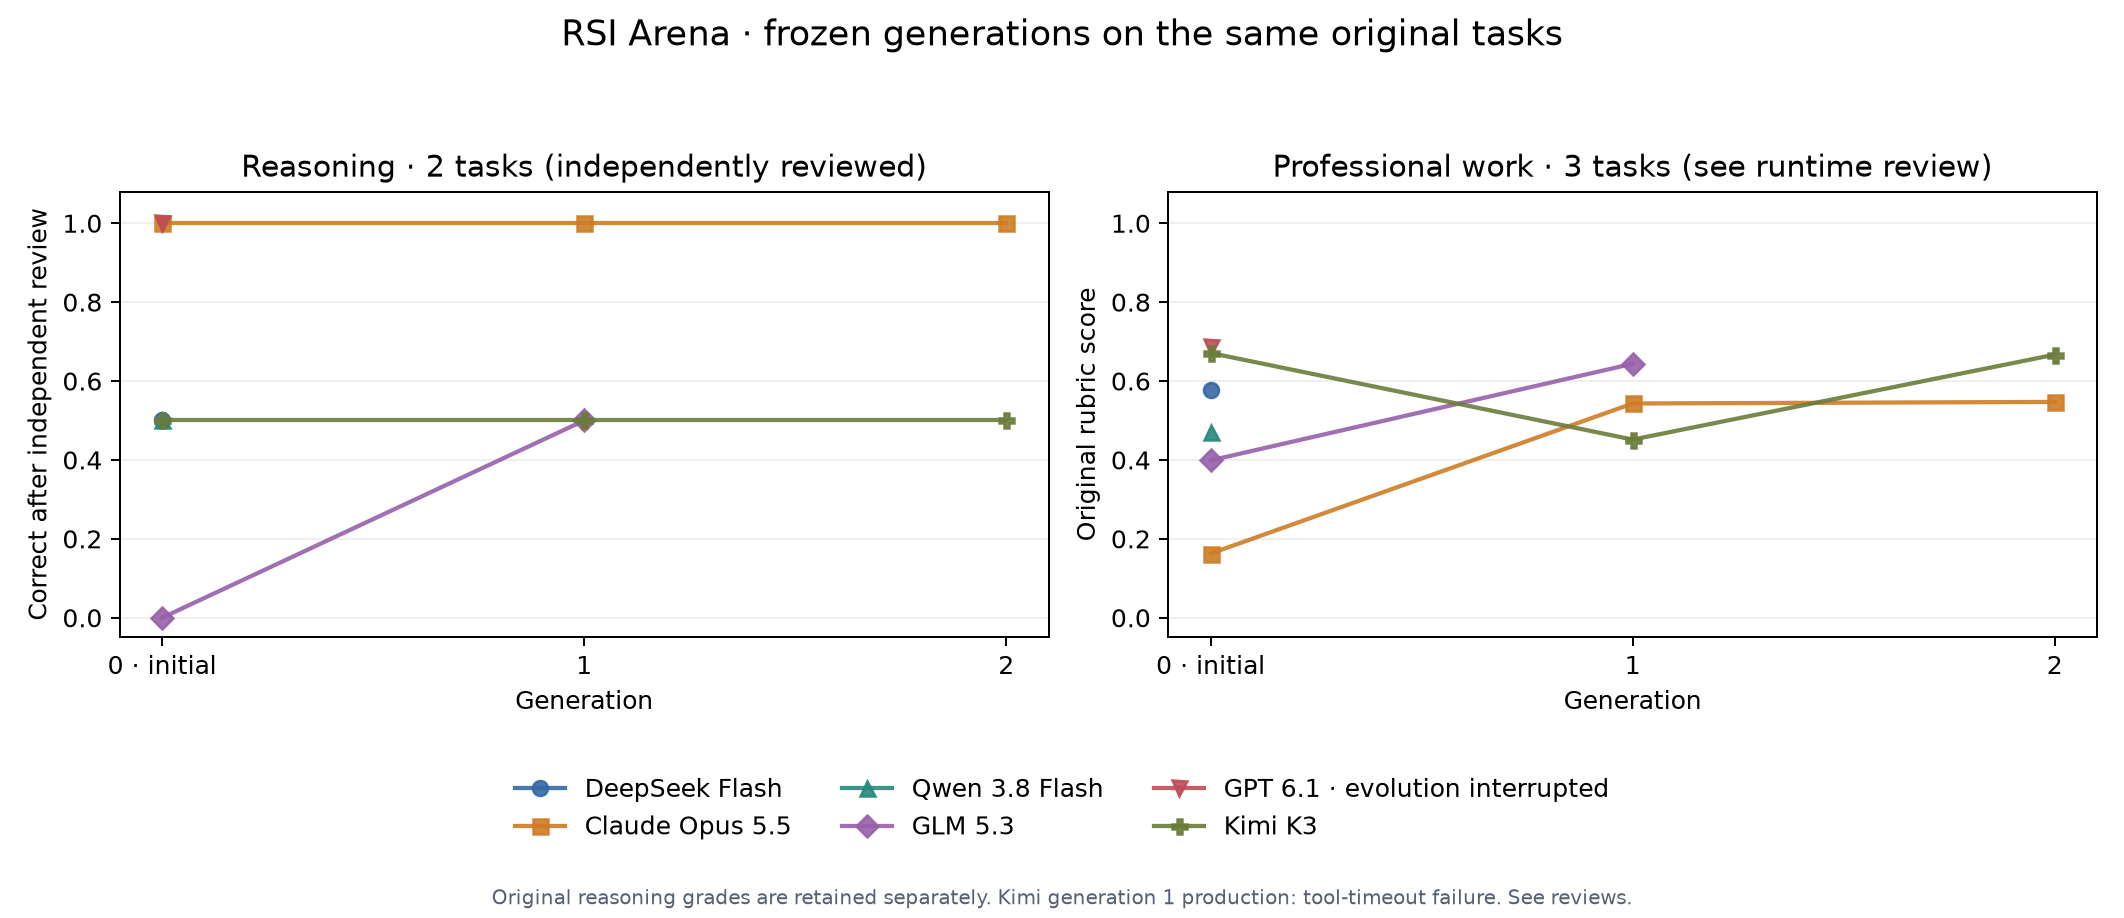
线性逻辑题发现误判:题目允许不同构造,但原裁判按参考形式判断,Claude 初代、第二代和 GPT 初代的有效构造因此得零分。相同规则已应用到全部版本;Kimi 第一代的构造有明确反例,仍判为不成立。
分段函数题也存在误判:Kimi 初代与第二代的写法不同于参考形式,但满足同一题意。一般证明、3,222 个点的检查和全部允许取值的验证均通过。两道题共发现 5 份此类误判,图中展示复核结果;原评分同时保留。全部版本的复核结果、证明与适用范围。
每个模型走到了哪里
| 模型 | 成功接班 | 初代推理复核 | 最后版本推理复核 | 初代职业评分 | 最后版本职业评分 |
| DeepSeek Flash | 0/2 | 1/2 题 | 1/2 题 | 57.8% | 57.8% |
| Claude Opus 5.5 | 2/2 | 2/2 题 | 2/2 题 | 16.3% | 54.7% |
| Qwen 3.8 Flash | 0/2 | 1/2 题 | 1/2 题 | 47.0% | 47.0% |
| GLM 5.3 | 1/2 | 0/2 题 | 1/2 题 | 39.9% | 64.4% |
| GPT 6.1 | 0/2 | 2/2 题 | 2/2 题 | 68.5% | 68.5% |
| Kimi K3 | 2/2 | 1/2 题 | 1/2 题 | 67.1% | 66.7% |
GLM 5.3 的第 2 代未能接班:新程序有语法错误,无法运行。
DeepSeek Flash 的第 1 代未能接班:改进过程没有正常交付新版本。
Qwen 3.8 Flash 的第 1 代未能接班:改进过程没有正常交付新版本。
GPT 6.1 的改进过程在服务中断中用完原定时限,后续改进停止。已存在的版本继续参加独立题。
表中职业评分表示满足原评分条目的程度。未产生后代的模型,用最后实际存在的版本作比较;缺少的代数没有补零。
Kimi 第一代的生产看板漏交还涉及运行故障:模型写了一条不会结束的命令,本机的单条命令超时没有返回。共同初代与第一代的独立副本都能复现这处故障。因此这次零分不能单独用来认定改进损害了能力。运行记录与独立复现。
同一模型改进前后:职业题原评分
| 模型 | 比较 | 题目来源 | 新版胜 / 平 / 旧版胜 | 未完成 |
| Claude Opus 5.5 | 第 1 代对第 0 代 | GDPVAL | 3 / 0 / 0 | 0 |
| Claude Opus 5.5 | 第 2 代对第 1 代 | GDPVAL | 1 / 2 / 0 | 0 |
| Claude Opus 5.5 | 第 2 代对第 0 代 | GDPVAL | 3 / 0 / 0 | 0 |
| GLM 5.3 | 第 1 代对第 0 代 | GDPVAL | 2 / 0 / 1 | 0 |
| Kimi K3 | 第 1 代对第 0 代 | GDPVAL | 2 / 0 / 1 | 0 |
| Kimi K3 | 第 2 代对第 1 代 | GDPVAL | 1 / 2 / 0 | 0 |
| Kimi K3 | 第 2 代对第 0 代 | GDPVAL | 2 / 0 / 1 | 0 |
上表按原题成绩逐题比较。下面的职业成果比较只依据原题要求、参考材料和实际成果,裁判看不到原评分条目。
匿名比较:改进后的工作是否更好
| 模型 | 比较 | 新版胜 | 持平 | 旧版胜 | 裁判分歧 | 未比较 |
| Claude Opus 5.5 | 第 1 代对第 0 代 | 2 | 0 | 0 | 1 | 0 |
| Claude Opus 5.5 | 第 2 代对第 1 代 | 1 | 0 | 1 | 1 | 0 |
| Claude Opus 5.5 | 第 2 代对第 0 代 | 2 | 0 | 0 | 1 | 0 |
| GLM 5.3 | 第 1 代对第 0 代 | 1 | 0 | 1 | 1 | 0 |
| Kimi K3 | 第 1 代对第 0 代 | 1 | 0 | 1 | 1 | 0 |
| Kimi K3 | 第 2 代对第 1 代 | 1 | 0 | 1 | 1 | 0 |
| Kimi K3 | 第 2 代对第 0 代 | 0 | 0 | 0 | 3 | 0 |
匿名比较:各模型最后版本
每个模型在三道职业题上分别与其他五个模型比较。两位裁判均交换左右位置,意见不同的题保留为分歧。
| 模型 | 最后版本 | 胜 | 持平 | 负 | 裁判分歧 | 未比较 |
| DeepSeek Flash | 第 0 代 | 6 | 1 | 6 | 2 | 0 |
| Claude Opus 5.5 | 第 2 代 | 11 | 0 | 0 | 4 | 0 |
| Qwen 3.8 Flash | 第 0 代 | 1 | 0 | 10 | 4 | 0 |
| GLM 5.3 | 第 1 代 | 3 | 0 | 9 | 3 | 0 |
| GPT 6.1 | 第 0 代 | 3 | 0 | 2 | 10 | 0 |
| Kimi K3 | 第 2 代 | 6 | 1 | 3 | 5 | 0 |
哪些比较需要进一步检查
在 66 组已有完整裁判判断的比较中,23 组存在两位裁判之间的分歧,8 组出现同一裁判在交换左右位置后改变偏好的情况。
两种比较都没有裁判分歧的有 36 组,其中 4 组的结果彼此不同。两份成果原分相同的有 7 组,其中 3 组在成对比较中出现了偏好。
逐题页面同时提供双方成果与裁判理由,可以检查差异是否来自原题要求、实际使用表现或裁判未能看到的材料。
两道推理题:原评分与复核结果
| 模型 | 版本 | 原判答对 | 复核答对 |
| DeepSeek Flash | 第 0 代 | 1/2 | 1/2 |
| Claude Opus 5.5 | 第 0 代 | 1/2 | 2/2 |
| Claude Opus 5.5 | 第 1 代 | 2/2 | 2/2 |
| Claude Opus 5.5 | 第 2 代 | 1/2 | 2/2 |
| Qwen 3.8 Flash | 第 0 代 | 1/2 | 1/2 |
| GLM 5.3 | 第 0 代 | 0/2 | 0/2 |
| GLM 5.3 | 第 1 代 | 1/2 | 1/2 |
| GPT 6.1 | 第 0 代 | 1/2 | 2/2 |
| Kimi K3 | 第 0 代 | 0/2 | 1/2 |
| Kimi K3 | 第 1 代 | 1/2 | 1/2 |
| Kimi K3 | 第 2 代 | 0/2 | 1/2 |
实际调用
| 用途 | 已发请求 | 正常完成的返回 | 失败或未完成的返回 | 已记录的失败用时 |
| 程序改进 | 970 | 961 | 9 | 43.0 分钟 |
| 做题 | 2564 | 2532 | 32 | 109.2 分钟 |
| 匿名评审 | 1341 | 888 | 453 | 1227.9 分钟 |
| 原题评分 | 162 | 115 | 47 | 236.8 分钟 |
失败用时按已记录的单次时长相加,并发的等待分别计入。部分失败已在后续请求恢复。所有调用都属于用户确认的六个模型。
接班关系核对
已核对 5 次有效接班:主持改进的确实是当代程序,独立评测使用的也是被接纳并冻结的程序。
首次接班前统一补齐职业评分的参考材料,并保留原草稿分数。评分修正不计作模型进步。后续实验需要增加独立重复、固定初代改进对照和跨模型使用,设置清单见项目讨论文档。